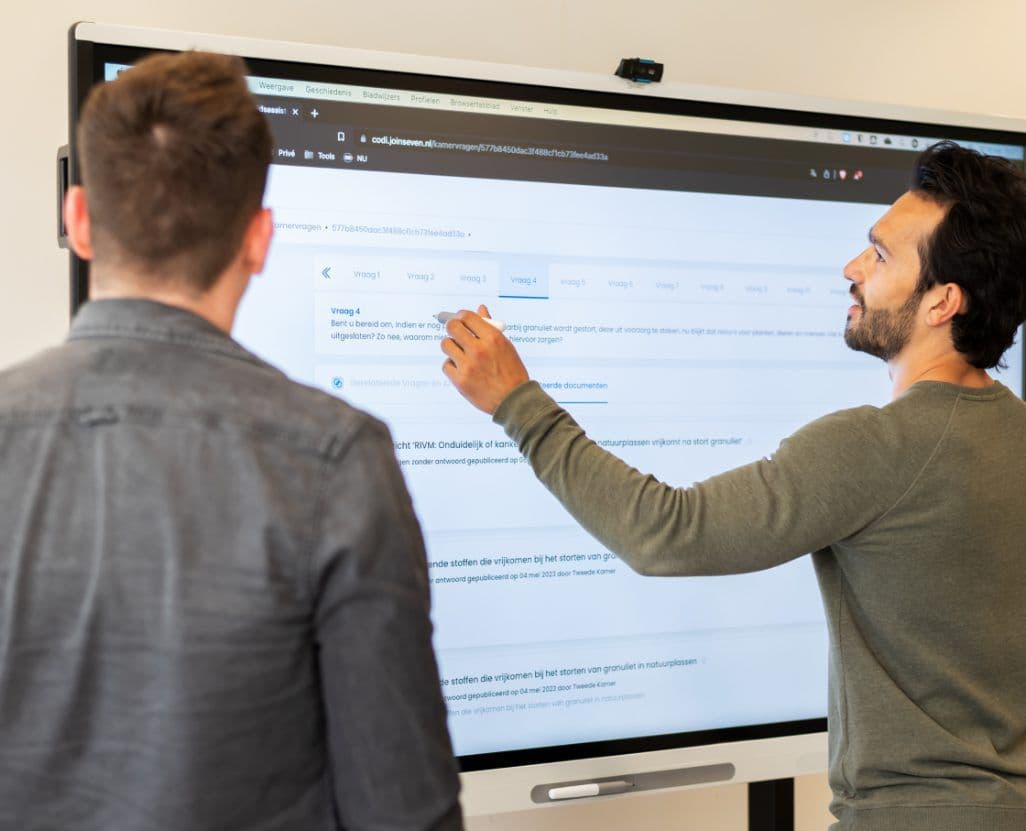
AI die werkt met jouw informatie
AI op maat laten ontwikkelen
Beleidsstukken, dossiers, wetten, rapporten: de informatie die er het meest toe doet, is zelden netjes gestructureerd. Wij bouwen AI die zulke informatie leest zoals je beste medewerker dat doet, alleen dan duizenden documenten tegelijk, met bij elk antwoord de bron.
Wat we bouwen
Van dossieranalyse tot assistent met bronvermelding
Sinds 2021 bouwen we AI-toepassingen voor organisaties waar informatie complex is en de inzet hoog: ministeries, uitvoeringsorganisaties, gemeenten en bedrijven. Uit die projecten ontstonden ook Codi en PRYSM, inmiddels zelfstandige labels. Dit is waar we goed in zijn:
Documenten en dossiers op schaal
Het Ministerie van Financiën laat ons AI bouwen die tijdlijnen op dossierniveau genereert. NPLW analyseert er warmteprogramma's van hele regio's mee, en voor Regioplan crawlden we de bestuursdocumenten van het onderwijsveld. Telkens hetzelfde recept: versnipperde bronnen erin, één bruikbaar overzicht eruit.
Antwoorden mét bron
Een antwoord zonder bron is in beleids- en beslissingswerk niets waard. Onze toepassingen verwijzen bij elke uitkomst naar het document en de passage waar hij vandaan komt, zodat je hem kunt controleren voordat je erop bouwt.
De mens houdt de regie
AI versterkt de mens, en de mens houdt de regie. In elke stap keurt een medewerker het resultaat, zoals in ons onderzoek voor de Belastingdienst naar slimme ondersteuning bij dossiervorming. Zo blijft de beslissing waar hij hoort: bij een mens die kan uitleggen waarom.
Training die je team meeneemt
We leveren geen zwarte doos af. Met prompttrainingen leerden beleidsmedewerkers van verschillende gemeenten verantwoord en effectief met AI werken, en datzelfde doen we voor jouw team bij elke oplossing die we opleveren.
Onze aanpak: de Data Discovery Sprint
Zo bouwen we jouw AI-oplossing
Elke AI-oplossing begint bij ons met de Data Discovery Sprint: in vier fasen van probleem naar werkende, gevalideerde oplossing. Zo weet je na afloop niet alleen óf AI jouw vraagstuk oplost, maar heb je ook de eerste werkende versie in handen.
Launch
We maken het vraagstuk scherp: welke taak of beslissing moet beter, welke informatie is daarvoor nodig en waar staat die nu? We praten met de mensen die het werk doen, niet alleen met de opdrachtgever.
Validate
We toetsen oplossingsrichtingen met de eindgebruikers en bouwen een eerste AI-prototype op echte data. Werkt het niet, dan weet je dat nu, en niet na maanden bouwen.
Awaken
We ontsluiten de bronnen, bouwen de datapijplijnen en maken van het prototype een toepassing die je team elke dag kan gebruiken, met bronvermelding en menselijke controle ingebouwd.
Deliver
We zetten de oplossing in jouw omgeving of hosten hem voor je, trainen je team en spreken af hoe beheer en doorontwikkeling eruitzien. Klaar is pas klaar als het in de praktijk werkt.


Aan de slag met AI?
Plan een kennismaking
Een gesprek van dertig minuten, gratis. Daarna maken we een proef op een set van je eigen documenten. Joris Petter neemt binnen één werkdag contact met je op.
AI-projecten uit ons portfolio
Bekijk ons werk
Automatisch tijdlijnen uit openbare documenten
Ministerie van Financiën
Voor het Ministerie van Financiën bouwen we een module die per dossier een tijdlijn opbouwt uit openbare stukken, op B1-niveau en met de bron erbij.
AI-oplossingenMaatwerk softwareAI-integratie in bedrijfsprocessen
Warmteprogramma's toetsen met AI
Nationaal Programma Lokale Warmtetransitie
Gemeenten moeten hun warmteprogramma langs een landelijke handreiking leggen. Voor het NPLW bouwen we de analyse die dat systematisch en navolgbaar doet.
AI-oplossingen
Omgevingsvisies analyseren met AI
Omgevingsdienst Regio Utrecht, RUD Utrecht en NCOD
Wat zeggen tientallen omgevingsvisies over bodem, water en ondergrond? We brachten ze terug tot één rapport, met de tegenstrijdigheden erin.
AI-oplossingen
Beleid analyseren voor de Omgevingswet
NCOD en vijf gemeenten
Vijf gemeenten en NCOD zochten een manier om bestaand beleid mee te nemen in de Omgevingswet. Uit deze pilot groeide de Omgevingswet-module van Codi.
AI-oplossingenMaatwerk softwareAI-integratie in bedrijfsprocessen
Dossiervorming bij de Belastingdienst
Belastingdienst
Een onvolledig dossier zet burgers bij de rechter op achterstand. We verkenden met de Belastingdienst hoe techniek helpt om dossiers compleet te krijgen.
AI-oplossingenPrototyping & innovatie
Prompttraining voor de overheid
Verschillende gemeenten
Een taalmodel gebruiken leer je niet uit een handleiding. In onze training oefenen beleidsmedewerkers met hun eigen nota's en casussen.
AI-oplossingen
De Lokale Schrijfcoach voor sportbeleid
NOC*NSF
Lokale partijen willen wel over sport schrijven, maar missen tijd en cijfers. Met NOC*NSF bouwden we een coach die onderbouwde tekstvoorstellen levert.
AI-oplossingenMaatwerk software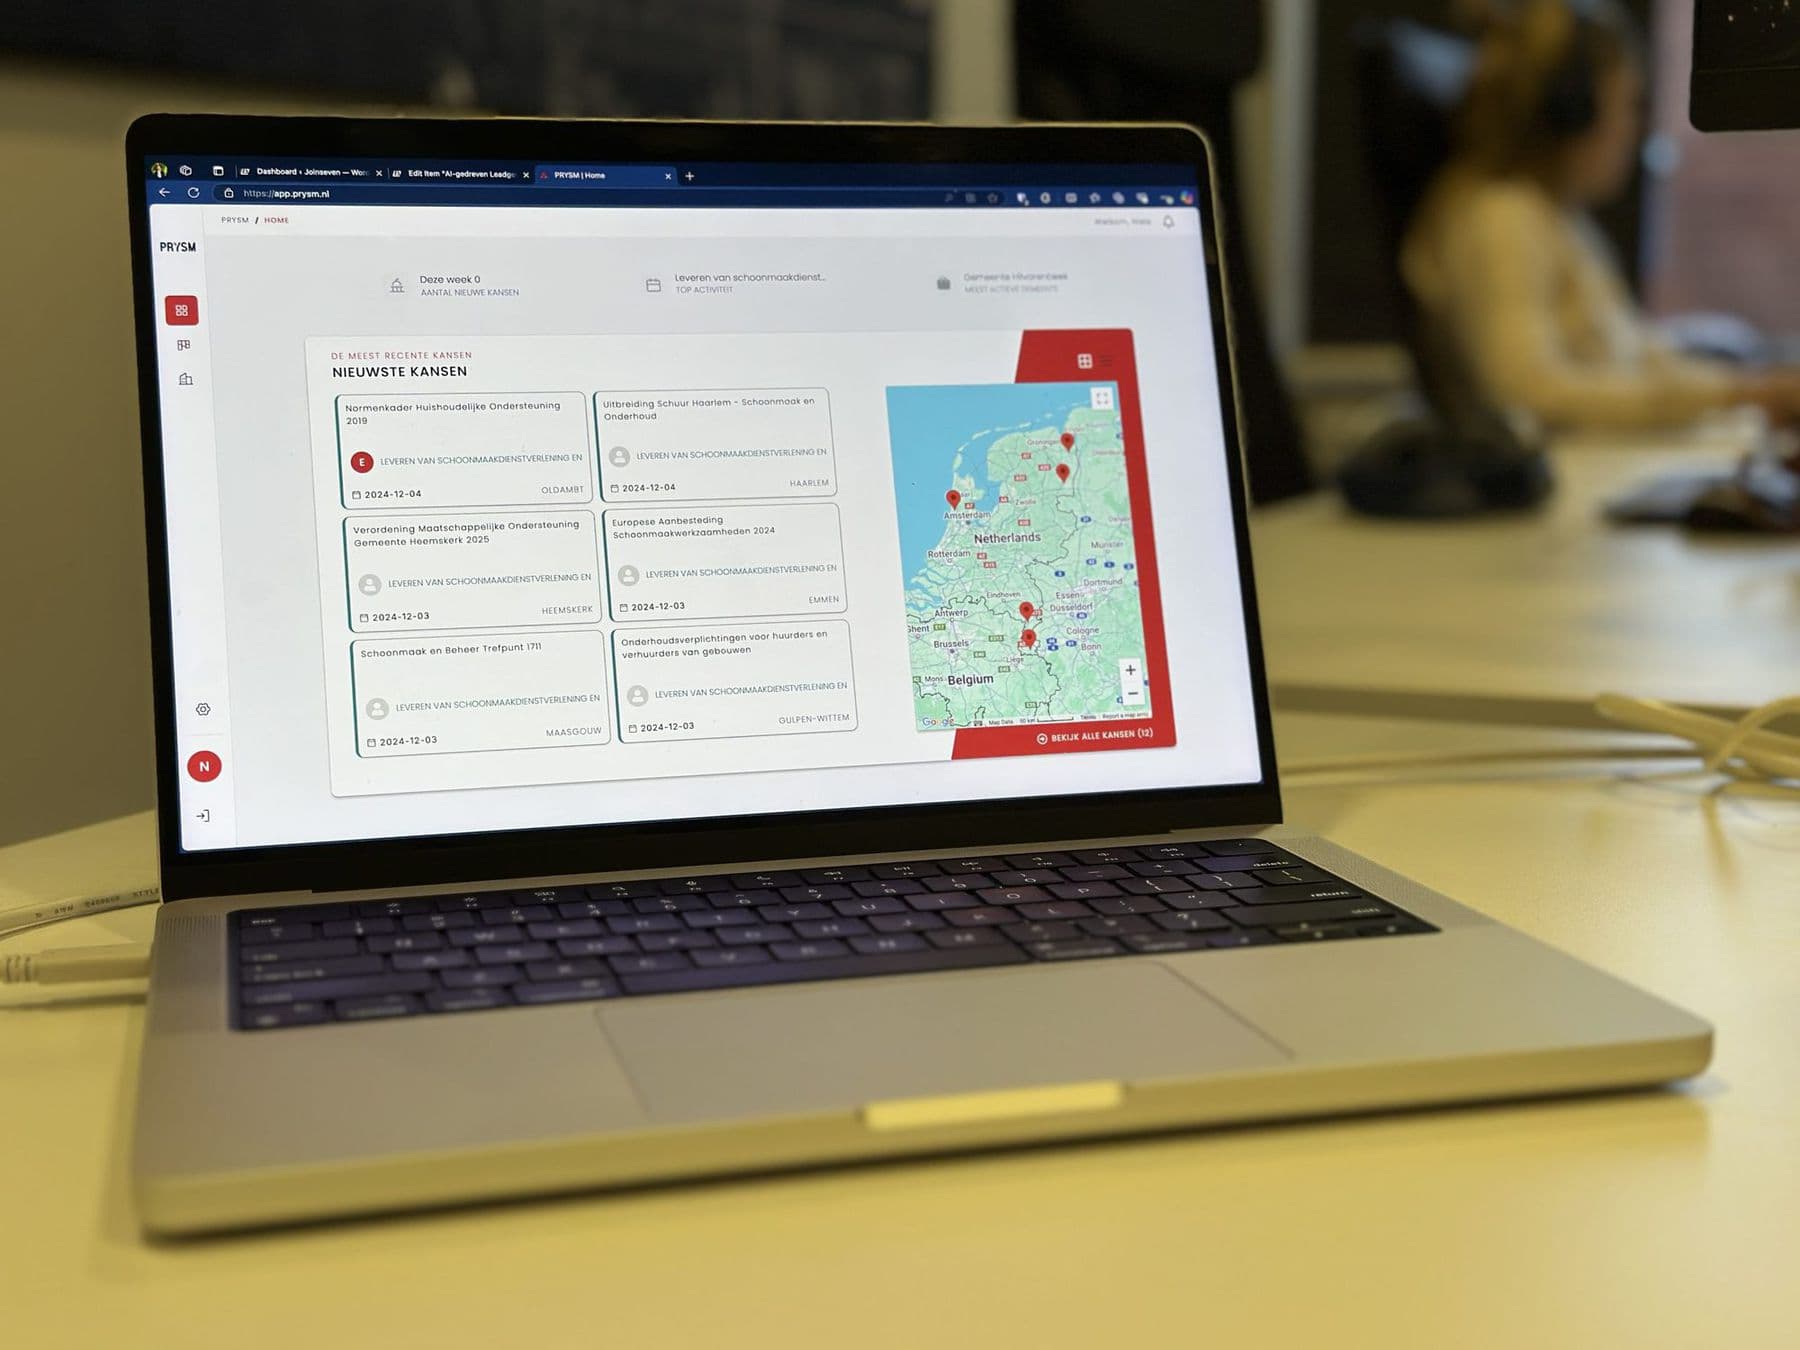
AI voor leadgeneratie bij de overheid
BMC
Overheden publiceren hun plannen ruim voor er een aanbesteding ligt. Met BMC bouwden we de oplossing die daarin kansen vindt. Daaruit groeide PRYSM.
AI-oplossingenPrototyping & innovatieSaaS & producten
Documenten crawlen voor onderzoek
Regioplan
Regioplan wilde weten of scholen hun managementstatuut publiceren. Onze crawler zocht bijna duizend scholen af, met bronvermelding per document.
Maatwerk softwarePrototyping & innovatie
Veelgestelde vragen
Vragen over AI inkopen
Dit zijn de vragen die vaak terugkomen als een organisatie AI wil laten bouwen. Staat de jouwe er niet bij, dan nemen we hem mee in het eerste gesprek.
Hoe lang duurt een AI-traject?
Dat hangt af van hoeveel bronnen je hebt en hoe rommelig ze zijn. De Kamervragen-pilot met zes rijksorganisaties liep vier maanden. We werken in de vier fasen van de Data Discovery Sprint (Launch, Validate, Awaken, Deliver) en toetsen eerst op een klein deel van je eigen documenten, zodat je vroeg ziet of het werkt. Een realistische planning maken we samen in het eerste gesprek, niet op deze pagina.
Wat als de AI niet doet wat we hoopten?
Dan weet je dat vroeg. In de Validate-fase toetsen we een eerste prototype op je eigen gegevens, samen met de mensen die het gaan gebruiken. Werkt het niet, of levert het te weinig op, dan kun je stoppen.
Waar draait het en wie beheert het?
Dat kan op twee manieren en jij kiest. Je draait de oplossing in je eigen omgeving, of wij hosten en beheren hem voor je in een omgeving die gescheiden is van die van andere klanten. Hoe we Europees kunnen werken, lees je op onze pagina over veilig en Europees werken. Welke hostingpartij we inschakelen, leggen we per opdracht vast in de bijlagen bij de verwerkersovereenkomst.
Hoe kopen we dit in?
Dat hangt af van hoe jouw organisatie inkoopt. Een eerste gesprek kost niets en verplicht tot niets; daarna maken we een voorstel dat past bij jullie inkoopregels. Of dat binnen een bestaande overeenkomst kan of een eigen traject vraagt, bespreken we in het eerste gesprek.
Van wie zijn onze gegevens en de oplossing?
Jij bent verwerkingsverantwoordelijke voor de gegevens en wij zijn verwerker. Wij verwerken gegevens alleen om de oplossing te laten werken, actueel te houden en te beveiligen, en niet voor eigen doeleinden. Loopt de beheerovereenkomst af, dan dragen we ze over of verwijderen we ze binnen dertig dagen. Wie de rechten op de software krijgt, leggen we per opdracht vast in de overeenkomst.
Wat hebben jullie van ons nodig?
Iemand die het werk kent en het resultaat kan beoordelen, en toegang tot voorbeelden van je eigen documenten of gegevens. Bij de sessies schuift een beslisser aan. In het eerste gesprek bepalen we wat er in jouw situatie nog bij komt.
Uit onze reeks over generatieve AI
Verder lezen
Blog
Wat is generatieve AI?
Wat de techniek doet, waarom een taalmodel niets weet, en de zes dingen die in onze projecten het verschil maken tussen slagen en stranden.
• 5 min leestijd
Blog
Een goede AI-use case kiezen
De klassieke misstap is een probleem zoeken bij een oplossing. Hoe je het omdraait, met de Kamervragen-casus als voorbeeld.
• 5 min leestijd
Blog
Verantwoord AI inzetten
Zes principes die wij aanhouden, vier gewoontes die het meeste verschil maken, en wat de EU AI Act sinds augustus 2026 van je vraagt.
• 6 min leestijd