Het fundament onder een AI-project
Data, systemen en processen: het deel onder de waterlijn waar een AI-project op strandt. Plus de vraag waar je model en je gegevens staan.
Deel 3 van de reeks
Het deel onder de waterlijn
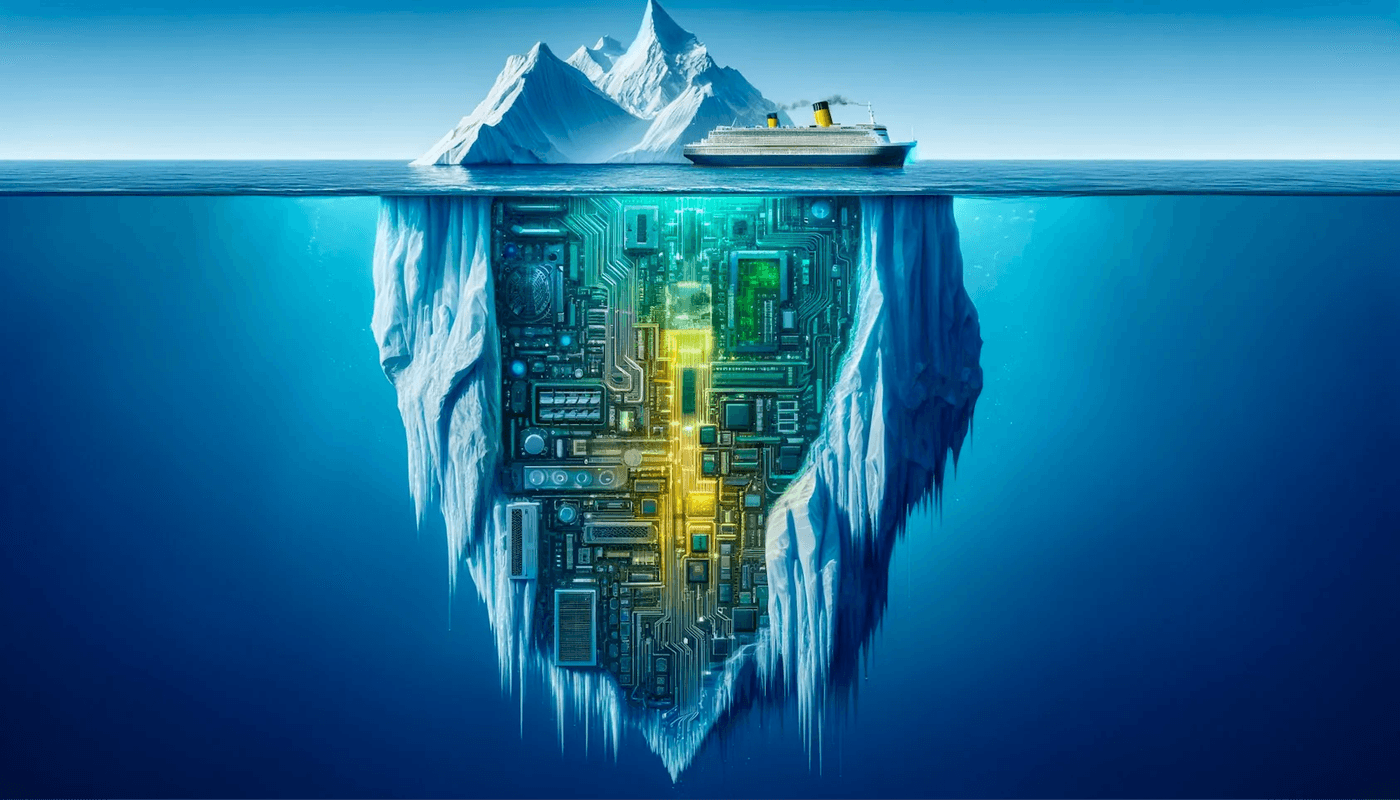
Een AI-project ziet er van buiten uit als een slim antwoord op een vraag. Daaronder zit alles wat dat antwoord mogelijk maakt: de data, de systemen en de processen. Wij gebruiken daar de ijsberg voor als beeld, omdat het klopt: het zichtbare deel is klein en het onzichtbare deel bepaalt of het blijft drijven.
Dit deel gaat over dat onzichtbare stuk. Niet als technische verhandeling, maar als de vragen die je moet stellen voordat je begint.
Van drie functies naar een berg werk
Neem het project rond Kamervragen. Aan de oppervlakte lag één vraag: hoe kunnen we Kamervragen sneller, nauwkeuriger en consistenter beantwoorden? Met beleidsmedewerkers kwamen we op drie functies:
- Een nieuwe vraag vergelijken met eerder gestelde vragen en de antwoorden daarop.
- Automatisch een dossier samenstellen van relevante documenten en passages.
- Een mogelijk antwoord formuleren als startpunt voor de medewerker.
Drie regels tekst. Maar zodra je erin duikt, blijkt dat je ook met tweeminutendebatten en mondelinge vragen te maken krijgt, dat de data op verschillende plekken staat en verschillend is gestructureerd (de site van de Tweede Kamer, Officiële Bekendmakingen, Rijksoverheid, en daarnaast sites van gemeenten en kennisinstellingen), en dat je voor elke functie andere gereedschappen nodig hebt om data op te halen, te bewaren, te doorzoeken en te verrijken.
Dat is geen argument om niet te beginnen. Het is een argument om dit vooraf uit te zoeken in plaats van halverwege.
Data: waar de kwaliteit vandaan komt
Elk AI-project begint hier, en de kwaliteit van je uitkomst hangt grotendeels af van de kwaliteit van je data. Op hoofdlijnen zijn het drie stappen.
- Ophalen. Per bron bepaal je hoe je erbij komt: een koppeling met een databank, een export, of het uitlezen van een website. Denk hier ook al na over de verversing, want een oplossing die je in productie wilt hebben, moet ook volgende maand nog kloppen.
- Klaarmaken. Opschonen en structureren. Lange teksten in stukken hakken en omzetten in getallenreeksen, zodat ze doorzoekbaar zijn en een model ze kan gebruiken. Onspannend werk, en het bepaalt of je later een antwoord met bron kunt geven.
- Beschikbaar stellen. De data toegankelijk maken voor de onderdelen die hem nodig hebben: de zoekmachine, het model, de interface.
Bij de Kamervragen ging het om eerdere vragen, antwoorden, debatverslagen, rapporten en nieuwsberichten. Wat daar uitkwam, was geen bestand maar honderdduizenden documenten (2023) waar je per vraag doorheen moet kunnen. Inmiddels zitten er in Codi ruim vijftien miljoen documenten uit honderden bronnen.
Systemen en gereedschap
Systemen: rekenkracht, opslag en zoeken
Voor tekst heb je andere dingen nodig dan voor cijfers. Tekst is ongestructureerd en verandert van vorm, dus je hebt flexibele opslag nodig en zoektechniek die op betekenis werkt en niet alleen op trefwoorden. Wij gebruiken daarvoor datalakes en NoSQL-opslag, met zoektechnologie op basis van Apache Lucene.
Zelf bouwen, kopen of gebruiken?
Niet alles hoeft van jou te zijn. Veel onderdelen huur je bij een cloudleverancier, en dat is meestal ook de verstandige keuze: je koopt beschikbaarheid, beveiliging en schaalbaarheid die je zelf moeilijk evenaart.
Waar het bij ons wel een expliciete keuze wordt, is waar die onderdelen staan. Wij zijn EU-first: we kunnen de volledige keten Europees leveren, van infrastructuur in Amsterdam tot Europese taalmodellen, en waar het past zelfs met open-sourcemodellen op Nederlandse bodem. Jij kiest. Verwerking buiten de EU gebeurt alleen in afstemming en passend bij de oplossing.
Dat is niet alleen een principe. Voor een overheidsorganisatie is het vaak een randvoorwaarde, en dan bepaalt het welke onderdelen je überhaupt kunt gebruiken. Vandaar dat die vraag in het fundament hoort en niet in de laatste week.
Processen: ook de olifantenpaadjes
De use case van een AI-project zit bijna altijd in een proces met zijstraatjes. Drie dingen om te doen voordat je bouwt:
- Teken het proces uit. Waar komt informatie binnen, wat gebeurt ermee, en hoe komt het eruit? Een nieuw systeem moet daarin passen, en soms een nieuwe stap toevoegen die iets oplevert.
- Zoek de olifantenpaadjes. Processen zijn zelden lineair. Bij de Kamervragen bleek dat er naast de officiële route ook tweeminutendebatten en mondelinge vragen bestaan, die allebei anders lopen. Die twee hadden een eigen benadering nodig, en dat had je niet gezien als je alleen de procesplaat had gelezen.
- Bepaal de rol van het systeem. Neemt het een stap over of ondersteunt het? Bij de Kamervragen kozen we het tweede: zoeken en presenteren doet het systeem, formuleren doet de medewerker. Waarom, staat in deel 5.
Wat je hieruit meeneemt
- Data, systemen en processen zijn het fundament. Een goed model op een slecht fundament levert een vlot antwoord op dat niet klopt.
- Ophalen, klaarmaken en beschikbaar stellen zijn drie aparte stappen, en de tweede kost het meeste tijd.
- Voor tekst heb je flexibele opslag en zoeken op betekenis nodig.
- Waar je onderdelen laat draaien, is een keuze die je vooraf maakt. Voor veel organisaties is het een eis.
- De verborgen routes in een proces bepalen vaker het ontwerp dan het officiële proces.
Verder lezen
De reeks over generatieve AI
Vijf stukken die samen één vraag beantwoorden: hoe krijg je AI aan het werk in een organisatie waar de inzet hoog is? Ze staan in leesvolgorde, maar je kunt er ook één uit pakken. Het valideren en het invoeren van een oplossing staan niet meer in deze reeks: die twee onderwerpen hebben we uitgewerkt per fase in de reeks over de Data Discovery Sprint.
Deel 1
Wat is generatieve AI?
Wat de techniek doet, waarom een model niets weet, en welke zes dingen een AI-project laten slagen.
Deel 2
Een geschikte use case kiezen
De klassieke misstap is een probleem zoeken bij een oplossing. Hoe je het omdraait, met de Kamervragen-casus als voorbeeld.
Deel 3
Het fundament eronder
Data, systemen en processen. Het deel onder de waterlijn, waar een AI-project op strandt of niet. Dit stuk lees je nu.
Deel 4
Welk model kies je?
Vier soorten taken vragen vier benaderingen. Plus de vraag die er in Nederland bij hoort: waar draait het model?
Deel 5
Verantwoord inzetten
Zes principes die wij aanhouden, en wat de EU AI Act sinds augustus 2026 van je vraagt.
Meer weten?
Wil je meer informatie over de technische randvoorwaarden voor jouw Generatieve AI project? Björn gaat er graag met je over in gesprek.